DeepSeek Harness 教程 · 第16讲 Workflow
第16讲 · Workflow——脚本化多阶段编排
《DeepSeek Harness 从上手到精通》系列 · 第五阶 多智能体编排篇
系列基于 deepseek-ai/deepseek-harness(0.1.0-rc.5,MIT)。本讲在 subagent(动态委派)之外,介绍另一种编排思路:把「流程」写成脚本。preview 阶段字段名可能微调,认准「阶段 / 依赖 / 衔接」三件事,具体以官方 workflow 文档为准。
一、Workflow 是什么:把"流程"写成确定性脚本
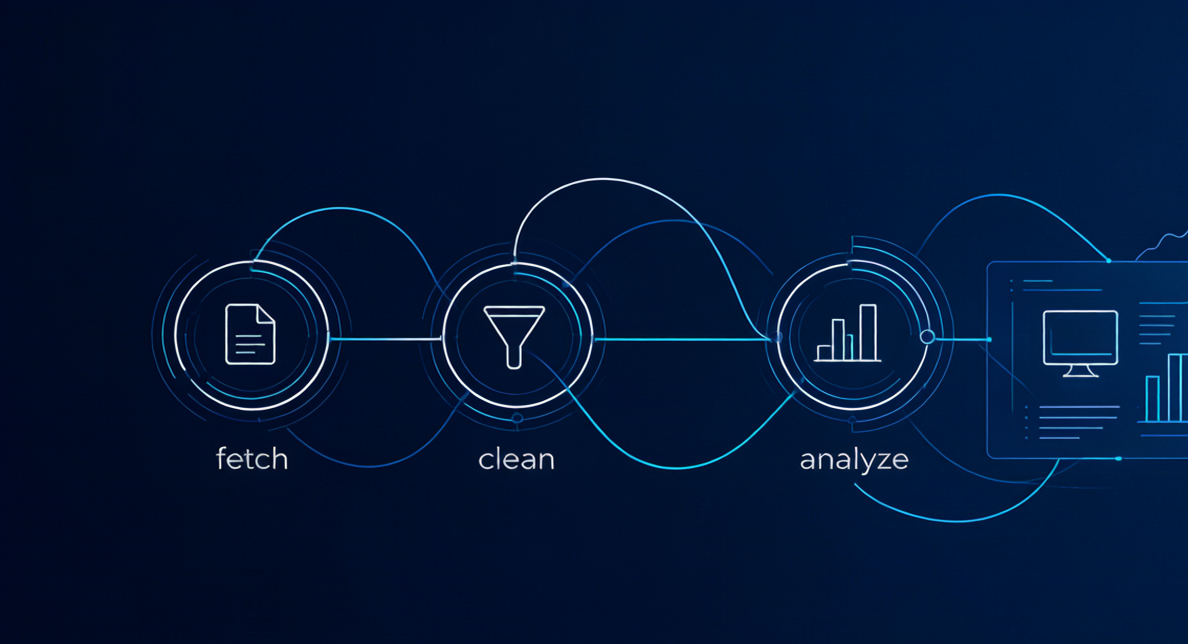
第 15 讲我们学会了 subagent——把任务委托给后台子代理,由 agent 自主决定怎么拆、派几个、怎么汇总。但有些任务其实步骤是固定的:先抓数据、再清洗、再分析、最后出报告。这种「每一步都确定、可重复跑」的场景,用 workflow 更合适。
一句话区分:subagent 是「让 agent 自己想办法」,workflow 是「你写死的流水线」。前者灵活、适合探索;后者可控、适合 ETL / 批处理 / 周期性报表这类「照章办事」的活。
二、脚本结构:阶段定义与输入输出衔接
一个 workflow 由若干个 stage(阶段) 组成。每个 stage 至少需要三样东西:
- name:阶段名,下游靠它引用上游产出;
- run:这一阶段要 agent 做什么(一句自然语言指令即可);
- depends_on:依赖哪些上游阶段,决定执行顺序与数据来源。
衔接的关键在输出:一个 stage 的产出会成为下一个 stage 的上下文。下面是一段示意配置(字段名为示例,请以官方文档为准):
workflows:
  research-report:
    stages:
      - name: fetch       # 阶段一:抓取
        run: "抓取目标页面的原始内容"
      - name: clean       # 阶段二:清洗,依赖 fetch
        run: "去除噪声,抽取正文与关键字段"
        depends_on: [fetch]
      - name: analyze     # 阶段三:分析,依赖 clean
        run: "提取核心观点并汇总数据"
        depends_on: [clean]
      - name: report      # 阶段四:报告,依赖 analyze
        run: "生成 Markdown 报告并保存"
        depends_on: [analyze]
三、无屏障流水线(pipeline):阶段间自动衔接
workflow 的精髓是 pipeline(无屏障流水线):当上游 stage 完成,下游自动拿到它的产出并开始执行,中间没有人工审批屏障。这带来两点好处:
- 加速:无需每步人工确认,整条流水线一气呵成,适合无人值守的批处理;
- 可复现:同样的输入永远跑出同样的阶段顺序,便于排错与回归。
注意:「无屏障」不等于「无安全」。pipeline 会自动执行每一步,若某 stage 含写文件 / 跑命令等敏感操作,仍要按第 10 讲配置好审批或权限预设,别让流水线在无人看管时乱改东西。
四、与 Subagent 配合:阶段内再派子代理
workflow 和 subagent 不是二选一,而是可以嵌套。例如「分析」阶段本身很重,你可以在该 stage 的指令里让 agent 派多个 subagent 并行调研不同维度,汇总后再交给下一阶段。
- name: analyze
  run: "派 2 个子代理分别做『观点提取』与『数据汇总』,再合并结果"
  depends_on: [clean]
  parallel: true     # 阶段内部并行派发子代理
这让「整体流水线 + 局部灵活委派」成为可能:骨架是你写死的可控流程,血肉里又保留了 agent 的自主性。
五、失败重试与断点续跑
长流水线最怕「跑到第 4 步挂了,前面 3 步全白干」。workflow 对此有两件武器:
- 失败重试:单个 stage 失败时按配置重试(可设次数 / 退避),不连累整条流水线;
- 断点续跑:已成功的 stage 会落盘(依赖第 6 讲的会话事件),重跑时从失败处接着来,不用重头来。
断点续跑依赖持久化的会话日志。如果会话被清掉、或换了台没有该日志的机器,就无法续跑——重要流水线记得备份事件日志。
六、动手练习:爬取 → 清洗 → 分析 → 报告
按本讲结构写一个四阶段 workflow 配置文件(可放进你的 patch.yml 或独立 workflow 文件),阶段为:fetch(抓取)→ clean(清洗)→ analyze(分析,内部派 subagent 并行)→ report(报告)。
# 运行你的 workflow(命令为示意,以官方 CLI 为准)
npx @deepseek-ai/dsh workflow run research-report \
  --input "https://example.com/article"
跑完后重点观察三件事:(1) 四个阶段是否按依赖顺序自动衔接;(2) analyze 阶段内部是否真的派出了并行子代理;(3) 若手动让 report 失败,修正后重跑是否跳过了前三个阶段(断点续跑验证)。
七、常见坑
- 把 workflow 当万能编排:需要 agent 自主判断、步骤不固定的任务,应改用第 15 讲的 subagent;
- pipeline 无屏障引发误写:含敏感操作的阶段务必配审批/权限预设,别让自动流水线乱改文件;
- 下游取不到数据:忘了在 stage 里声明输出,导致
depends_on拿不到上游产物,检查阶段名拼写; - 断点续跑失败:会话日志被清或换机导致无法续跑,重要任务先备份事件日志;
- 阶段内并行失控:subagent 没设并发上限,一次炸出几十个进程,给
parallel加并发上限。
八、官方文档对应章节
docs/中 workflow / pipeline / multi-agent 编排相关章节- 第 15 讲 subagent(workflow 内部并行委派的基础)
- 第 6 讲会话事件(断点续跑依赖的事件日志机制)
本讲内容基于 DeepSeek Harness 官方文档与项目源码整理,仅供学习参考,具体命令与配置请以官方最新版本为准。系列文章配合源码仓库食用效果更佳:https://github.com/deepseek-ai/deepseek-harness
咨询 DeepSeek Harness 相关问题,请加微信:A0qingfengyuan_01
个人观点,仅供参考,如有不对之处,请多包涵,欢迎指出。本文由 AI 协助完成!
欢迎扫码关注公众号与作者微信,获取更多实用干货