Stirling-PDF:把"在线 PDF 工具"踢出局的开源神器
一篇面向「重视隐私 + 需要批量处理 PDF」的技术干货。所有数据均于 2026-08 核实自 GitHub 官方仓库与多个第三方评测。
一、先说痛点:你的 PDF 正在被"免费工具"偷看
日常办公里,我们几乎每天都要和 PDF 打交道:合并合同、拆分标书、给报表加密、把扫描件转成可搜索的文字……
但大多数人图方便,直接把文件丢进"某某在线 PDF 工具"——你永远不知道这些网站背后是谁,文件会不会被原样留存、转卖或训练模型。 财务表、身份证、标准文档、商业合同,一旦上传就脱离了你的控制。
那有没有一种可能:功能比在线工具全、数据完全留在自己手里、还免费?
有。它就是今天要聊的 Stirling-PDF。
二、Stirling-PDF 是什么
Stirling-PDF 是一个本地托管(locally hosted)的 Web 端 PDF 全能处理工具,由 Stirling-Tools 团队开发,被 GitHub 官方描述为 "#1 PDF Application on GitHub"(GitHub 上排名第一的 PDF 应用)。
它的核心哲学就一句:所有文件处理都在你的本地机器或私有服务器上完成,任务结束自动清理临时文件,从根本上杜绝敏感数据外泄。
它提供三种使用形态:
- 浏览器网页:部署后局域网/内网访问,多人共享一台处理服务;
- 桌面客户端:基于 Tauri 打包的跨平台原生应用,自带 JRE;
- 私有 REST API:对外提供 OpenAPI(Scalar 文档),可接自动化流水线。
核实过的硬数据(2026-08)
| 指标 | 数值 |
|---|---|
| GitHub Star | 约 8.9 万(多个 2026-08 评测落在 89,600–89,990 区间) |
| Fork | 约 8,100 |
| 贡献者 | 300+ |
| 最新版本 | v2.14.3(2026-08-06 发布,hotfix) |
| 定位 | GitHub 星标最高的 PDF 类项目 |
三、50+ 工具,覆盖你能想到的所有 PDF 操作
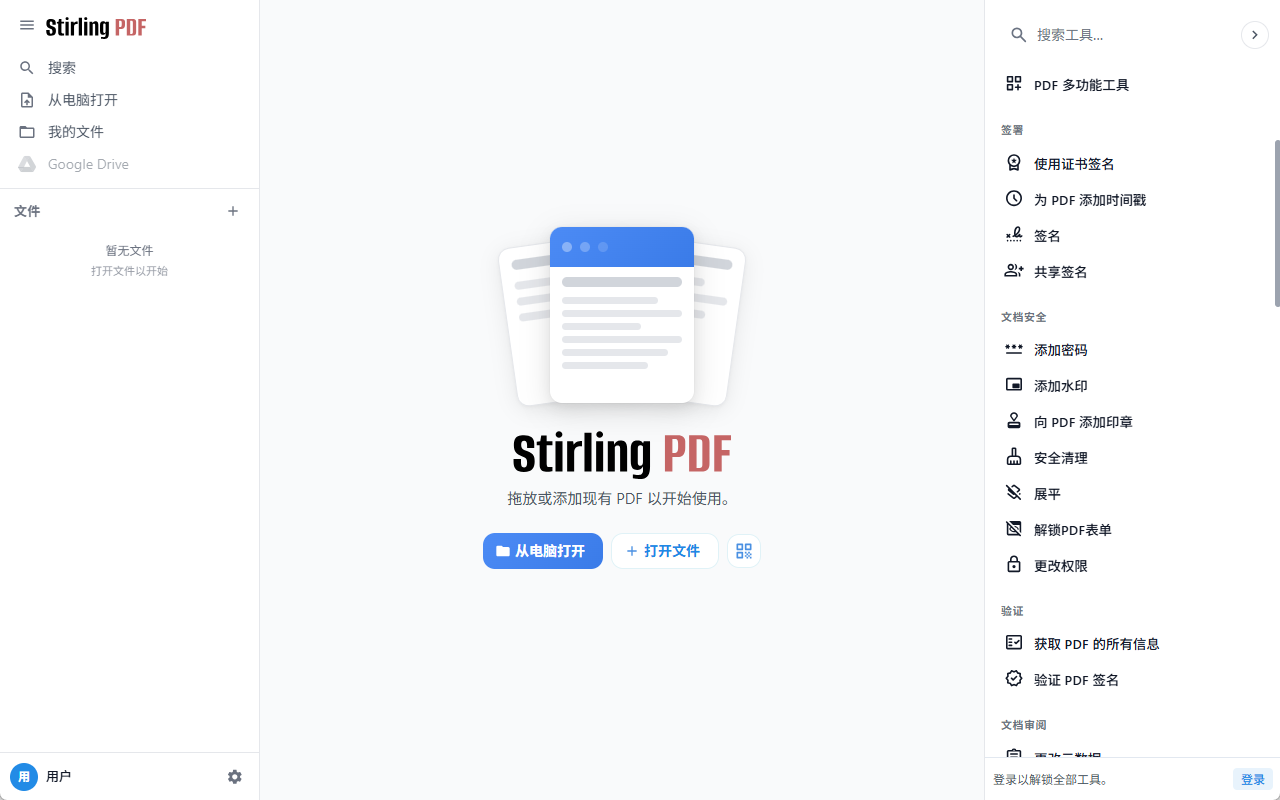
Stirling-PDF 把常用 PDF 操作做成了一个"工具箱",目前有 50 多个功能,按场景大致分为:
- 页面操作:合并、拆分、旋转、重排、删除指定页;
- 格式转换:PDF ⇄ Office(Word/Excel/PPT,借助 LibreOffice)、PDF ⇄ 图片、HTML → PDF(WeasyPrint);
- 压缩与优化:压缩体积、用 qpdf 做底层优化;
- 安全与合规:加密/解密、加/去打开密码、脱敏(redact)、水印、数字签名、增删文档元数据;
- 识别:OCR 文字识别(Tesseract)、结构化数据提取(Python 引擎);
- 批注与表单:注释、表单填写;
- 修复与清理:修复损坏 PDF、清理多余冗余数据;
- 多语言界面:基于 i18next,内置几十种语言包。
划重点:上面这些全部免费、全部本地运行。
四、技术架构:一个"三语言"的开源平台
很多人以为它只是"PDFBox 套了层网页",其实早就不是了。Stirling-PDF 已经长成一个真正的多服务开源自托管平台:
- 后端(Java):Spring Boot 4.0.6,跑在 Java 25(JDK 25) 上,用 Gradle 构建;核心 PDF 引擎是 Apache PDFBox 3.0.8,转档靠 LibreOffice、优化靠 qpdf;加密签名用 BouncyCastle 1.85、静态加密用 Google Tink 1.23.0;企业级 SSO 走 Spring Security SAML 7.1.0 / OpenSAML 5.2.1;接口限流用 Bucket4j;还能直连 S3 / SFTP / SMB 做文件进出处。
- 前端(TypeScript):React + Vite,Mantine UI + TailwindCSS,用 PDF.js 做浏览器内渲染,IndexedDB 做本地暂存。
- 引擎(Python):独立的 FastAPI 服务(用 uv 管理),专门负责 OCR 和结构化提取——因为 Python 生态的 OCR/ML 工具确实比 JVM 上成熟。
- 桌面端(Rust):Tauri 打包,跨平台,自带 JRE。
一句话:它不是"一个 Jar 包",而是 Java 后端 + Python 引擎 + TS 前端 + Rust 桌面端四个独立代码库拼起来的平台。(这也是它技术债和架构复杂度偏高的原因,自托管时docker 部署最省心。)
五、部署:一条命令跑起来
最省事的方式是 Docker。一行即可拉起:
docker run -d \
  -p 8080:8080 \
  -v $(pwd)/data:/configs \
  -e DOCKER_ENABLE_SECURITY=false \
  --name stirling-pdf \
  stirlingtools/stirling-pdf:latest
镜像名说明:官方 Docker 镜像现用stirlingtools/stirling-pdf:latest,历史上曾用frooodle/s-pdf,以官方文档为准。开启安全登录请把DOCKER_ENABLE_SECURITY设为true并配置账号。
除了单容器,还支持 Docker Compose、桌面客户端、以及暴露 REST API 接自动化(新版本还加入了 Pipelines / Policies 概念,可配置"始终运行"的自动处理流水线)。
六、开源与商业:open-core 模式(重要提醒)
Stirling-PDF 采用 open-core(开放核心) 模式,这点务必说清楚:
- 免费、开源、可自部署的部分在
app/core:合并、拆分、压缩、脱敏、OCR、转换等核心工具,MIT 风格许可,个人和小团队自托管完全没问题; - 企业级能力在
app/proprietary、app/saas:SSO、审计日志、托管 SaaS、计费(real credits / payment flows)等,是专有代码。
正因为仓库里混了开源与专有代码,GitHub 的许可证检测器会把它标成 NOASSERTION(无法干净归类)。对个人自托管基本无影响,但如果你打算基于它做商业流程,建议先读一遍 LICENSE 再决定。
七、适合谁 / 不适合谁
适合:
- 重视隐私、不想把合同/证件/标准文档丢给在线工具的个人;
- 需要批量处理 PDF 的团队(如标准体系、档案、法务);
- 想自建一套文档处理工具的技术人。
不太适合:
- 只想偶尔转一次格式、且完全不想碰 Docker 的小白(当然,桌面版可以救一下)。
八、快速上手
- 有 Docker 环境 → 直接跑上面的
docker run; - 不想折腾 → 下载桌面客户端(Windows/macOS/Linux);
- 想研究源码 / 追更 → 去 GitHub 仓库:
4.如果你觉得GitHub下载太慢,请关注底部微信公众号,回复关键词:Stirling-PDF,获取百度网盘下载链接。
九、小结
在线 PDF 工具用一次,你的文件就"裸奔"一次。Stirling-PDF 用"本地托管 + 50+ 免费工具 + 开源自部署"把隐私权和功能完整性同时还给了你。 无论你是个人防泄露,还是团队批量处理文档,它都值得放进你的自托管清单。
想看实际效果?本号后续会出一篇 Stirling-PDF 实操演示,欢迎关注。
个人观点,仅供参考,如有不对之处,请多包涵,欢迎指出。本文由AI协助完成!
欢迎扫码关注公众号与作者微信,获取更多实用干货